多智能体协作实战:用 Agent Harness 构建自主工作流
多智能体协作实战:用 Agent Harness 构建自主工作流
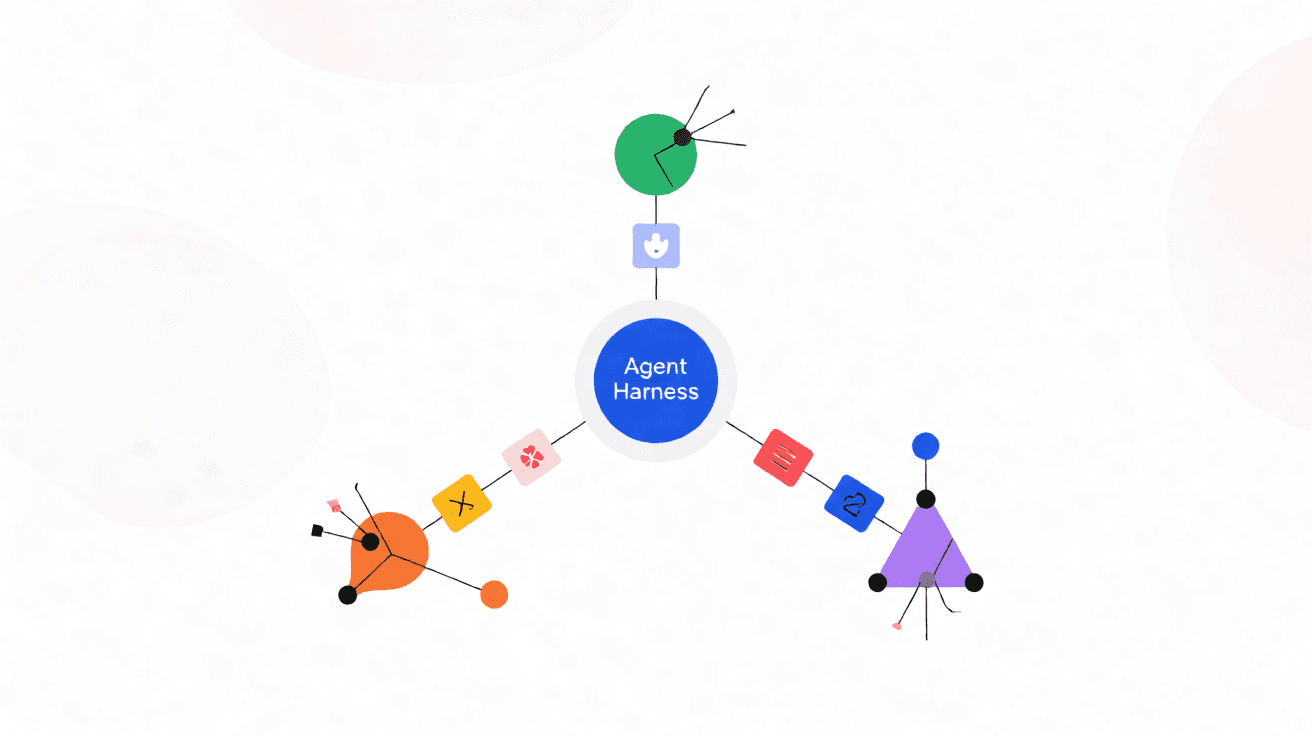
构建高效的多智能体系统,核心在于解耦「规划」与「执行」,并引入上下文记忆来维持任务连贯性。通过 Agent Harness 框架,我们可以在单一应用中编排多个专业化 Agent,让它们像人类团队一样协作——有人负责调研(RAG),有人负责代码实现,有人负责审核。
为什么单一 Agent 搞不定复杂任务
在接触 Agent Harness 之前,我尝试过用单个 Claude API 调用完成「从数据库提取销售数据 -> 生成 Python 分析报告 -> 自动部署到 Staging 环境」的全流程任务。结果非常糟糕:Prompt 长度爆炸,模型在中间步骤容易「遗忘」初始指令,且一旦某步出错(比如 SQL 语法错误),整个流程无法回滚或重试。

单一 Agent 的问题在于它没有「角色边界」。我给它一个复杂任务,它会试图一次性处理所有逻辑,导致幻觉率飙升。而多智能体架构的本质,是将大问题拆解为小角色的串行或并行协作。Agent Harness 的价值就在于提供了一个标准化的容器(Harness),让这些角色知道何时把控制权交给下一个角色,以及如何传递上下文。
核心架构:Harness 如何编排 Agent
在 Agent Harness 中,我们不再编写冗长的 if-else 状态机,而是定义一个「工作流图」。每个节点是一个 Agent,边是触发条件。
以构建一个「智能客服工单处理系统」为例,我设计了三个协作角色:
- Intake Agent(录入员):负责从用户自然语言中提取关键实体(订单号、问题类型),并调用 RAG 检索历史知识库。
- Solver Agent(解决者):基于 Intake Agent 的结构化数据,调用工具生成解决方案草稿。
- Reviewer Agent(审核员):检查 Solver 的输出是否符合合规要求,决定是「批准发布」还是「返回修改」。
关键在于自适应记忆(Adaptive Memory)。当 Reviewer Agent 要求修改时,Intake Agent 不会从头开始重新检索,而是将之前的 RAG 结果作为「长期上下文」传递给 Solver Agent,避免重复计算。我在调试中发现,如果不显式设置这个记忆传递机制,每次循环都会重新发起耗时的向量检索,导致响应延迟从 2 秒劣化到 15 秒以上。
落地实战:最小可运行示例
以下是使用 Agent Harness 风格定义的最小协作工作流代码。这里我们模拟一个简化的「代码审查助手」:一个 Agent 负责读取代码,另一个负责生成报告。
from agent_harness import Harness, Agent, Tool

# 1. 定义工具:假设我们有一个模拟的代码分析工具
def analyze_code_snippet(code: str) -> dict:
    # 模拟调用外部 LLM 进行静态分析
    return {"issues": ["缺少类型注解", "潜在空指针风险"]}

# 2. 定义两个专业化 Agent
code_agent = Agent(
    name="CodeScanner",
    model="claude-3-opus",
    tools=[analyze_code_snippet],
    system_prompt="你是一个严谨的代码审计员。请分析代码并返回 JSON 格式的问题列表。"
)

report_agent = Agent(
    name="ReportWriter",
    model="gpt-4o",
    system_prompt="你是一个技术文档撰写人。根据代码扫描结果,生成一份简洁的修复建议报告。"
)

# 3. 定义 Harness 工作流:串行协作
workflow = Harness(
    start=code_agent,
    next_step={
        code_agent: report_agent  # 当 CodeScanner 完成后,自动转交给 ReportWriter
    },
    memory_mode="context_window"  # 启用自适应记忆,传递中间结果
)

# 4. 执行
if __name__ == "__main__":
    result = workflow.run(initial_input="def process_data(raw):\n    return raw['id']")
    print(f"最终报告:\n{result.final_output}")
在上述代码中,memory_mode="context_window" 是关键配置。它确保 ReportWriter 不仅能看到自己的输入,还能访问 CodeScanner 的历史调用日志,从而生成更有针对性的建议,而不是泛泛而谈。
常见陷阱与优化建议
在实际生产环境中部署多智能体系统,我遇到了几个典型坑点,建议避开:
- 循环依赖死锁:如果 Reviewer 总是拒绝 Solver 的输出,而 Solver 又依赖 Reviewer 的反馈,系统会陷入无限循环。我建议在 Harness 中设置
max_turns=5上限,并添加一个专门的Fallback Agent来处理僵局,由人工介入。 - 上下文污染:当多个 Agent 共享同一个全局记忆库时,Agent A 的中间结论可能会干扰 Agent B 的判断。解决方法是使用联邦记忆(Federation),让每个 Agent 拥有独立的私有记忆槽,仅通过标准化的接口交换必要信息,而非共享整个历史记录。
- 成本失控:多智能体意味着多次 LLM 调用。务必为每个 Agent 设置
cost_budget,并在 Harness 层面监控总 Token 消耗。如果发现某个环节耗时异常,可以考虑将高精度模型(如 Opus)替换为轻量级模型(如 Haiku)进行预处理,只在最终决策环节使用强模型。
Agent Harness 提供的价值不仅是编排,更是可观测性。它能清楚地展示每个 Agent 的输入、输出和耗时,这对排查复杂链路中的瓶颈至关重要。如果你正在构建需要长期维护的 AI 应用,这种模块化思维是必经之路。
下一步,你可以尝试将真实的 PostgreSQL 数据库接入 Intake Agent,实践 RAG 与结构化数据的混合查询。
本文首发于 多智能体协作实战:用 Agent Harness 构建自主工作流 — https://lyxq.com.cn/en/blog/multi-agent-harness-workflow
转载或引用请注明出处,商业使用请联系作者获得授权。