用可视化工作流编排AI自动化任务的实操避坑指南
用可视化工作流编排 AI 自动化任务的实操避坑指南

核心痛点:为什么我弃用了纯代码链路
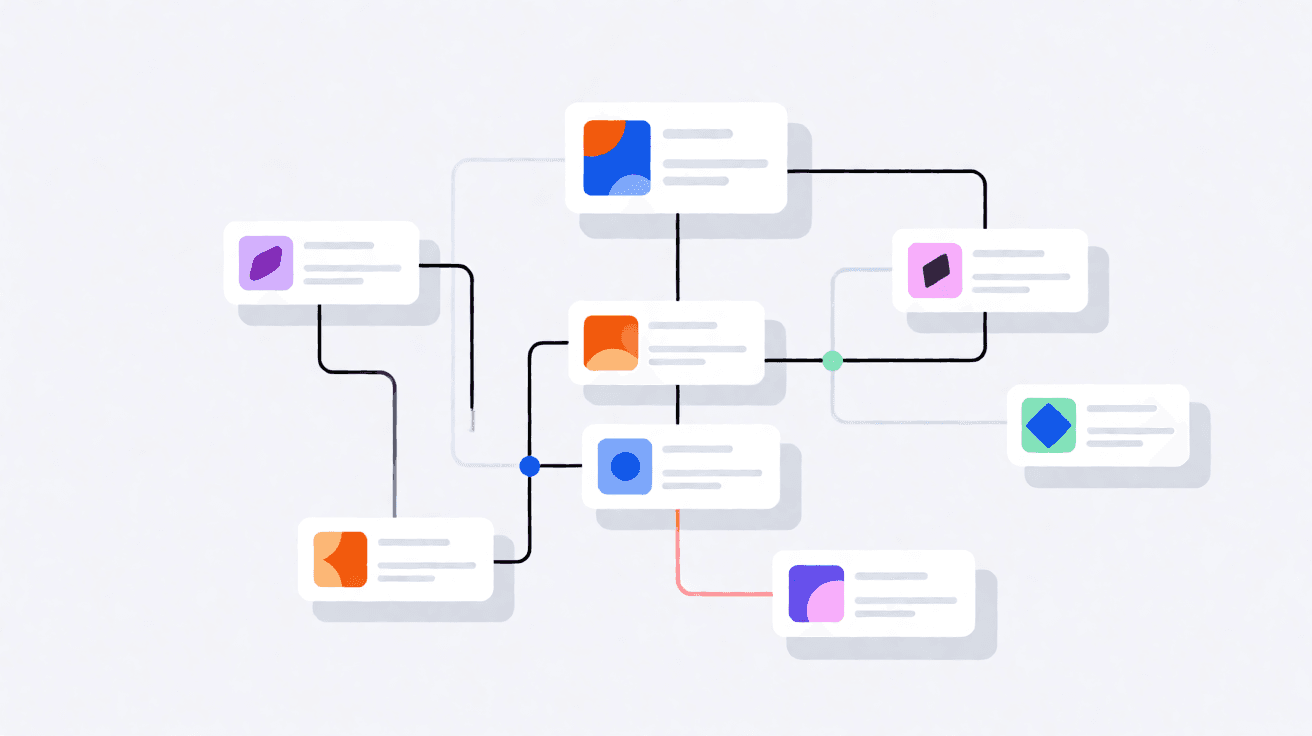
我一开始也执着于用 Python 脚本串起所有的 AI 调用,但面对多分支、需要人工介入审批或者长时间运行的任务时,纯代码的状态机写得让人头秃。我现在的做法是直接用支持拖拽连线的可视化工作流平台,把大模型节点、条件分支、外部 API 调用画在一张图上。这样不仅改逻辑时直观,调试某个特定节点的 Prompt 也不必跑整个链路,省去了大量在终端里查日志的时间。
节点化大模型调用的参数隔离
在做具体编排时,我会把「大模型调用」封装成独立的黑盒节点。这里有个容易踩的坑:上下文传递。如果上游节点生成的文本太长,直接塞给下游的大模型节点往往会导致截断或幻觉。我的习惯是在两个大模型节点之间加一个「文本清洗与总结」节点,专门负责把冗长的结果压缩成结构化 JSON。这样不管前一步生成了多少废话,后一步能拿到的永远是干净的参数。
常见错误:长耗时任务的异步挂起
很多开发者在编排“爬取网页并让 AI 分析”的流程时,习惯性用同步阻塞。一旦遇到慢响应或者大模型 API 排队,整个工作流就会卡死,前端页面也转圈圈。我一般是给这类节点开启异步轮询机制。具体做法是,在 API 请求节点设置一个“轮询间隔”和“最大重试次数”,比如每 5 秒检查一次任务状态。这样即使后台还在运算,前端也能保持响应,不会把整个系统拖垮。
复杂场景的条件分支路由
AI 的输出永远不是百分之百确定的,特别是让它做分类或者意图识别时,经常会有意想不到的回答。在工作流编排里,千万别指望 AI 节点能100%走你设计好的标准路径。我一般会在大模型节点后紧跟一个“条件路由”节点,专门写正则或者关键词匹配。如果发现 AI 返回了脏数据,就强制走一条兜底分支,去调用一个传统的规则引擎或者默认回复,保证业务的底线不破。
监控与调试:日志必须带链路 ID
当你的流程图连线超过十个节点后,排查问题就成了噩梦。我在部署任何生产级工作流前,都会强制在起始节点注入一个唯一的 trace_id。这个 ID 会随着数据在各个节点间流转。这样一来,当有客户反馈某个任务失败时,我拿着这个 ID 去后台日志一搜,立刻就能看到它在哪个节点卡住了,省去了无头苍蝇般的猜测。
相关阅读 / 下一步 如果你对底层大模型的上下文窗口管理机制感兴趣,可以去看看关于 Token 预算计算的进阶文章,这能帮你更好地设计那些中间处理节点。
本文首发于 用可视化工作流编排AI自动化任务的实操避坑指南 — https://lyxq.com.cn/en/blog/visual-workflow-ai-automation-practice
转载或引用请注明出处,商业使用请联系作者获得授权。